

Si estás pagando una suscripción a Claude (desde los $20 hasta los $200 mensuales) y alguna vez has visto ese temido mensaje de «límite alcanzado» a media tarde, respira hondo: no es culpa del modelo, es culpa de tu flujo de trabajo.
Como desarrolladores fullstack y estrategas de IA, hemos analizado cientos de conversaciones y llegado a una conclusión incómoda: la mayoría de los usuarios profesionales están literalmente quemando dinero en tokens innecesarios. No porque Claude sea caro, sino porque lo usan como si fuera un chat de WhatsApp.
La realidad técnica es brutal pero esperanzadora: tu suscripción está fuertemente subsidiada por Anthropic. Un usuario eficiente puede consumir el equivalente a más de $3,000 USD en tokens de API sin pagar un centavo adicional. Pero ese subsidio tiene un límite, y superarlo significa ser degradado a modelos inferiores o, directamente, quedarte fuera del juego hasta el siguiente ciclo.
Hoy vamos a cambiar eso. Abandona el modo «usuario recreativo» y activa el modo ingeniero.
1. Ramificar la conversación: tu aliado contra el contexto acumulado
El problema técnico
Los modelos basados en transformers procesan todo el historial de la conversación en cada turno. En una sesión larga (cientos de intercambios, cientos de miles de tokens), cada nuevo mensaje —incluso un simple «gracias»— implica reenviar al modelo todo ese contexto acumulado.
El matiz importante: prompt caching
Esto no se traduce directamente en «pagar el reprocesamiento completo cada vez». La API de Claude implementa prompt caching: si el prefijo de la conversación no cambia entre turnos, esos tokens se cobran al ~10% del precio normal de entrada (con un pequeño sobrecoste la primera vez que se escriben en caché, y una ventana de validez de unos 5 minutos que se renueva con cada uso).
En la práctica, esto significa que un «hola» en medio de un chat de 500k tokens no cuesta varios dólares si el caché sigue activo —cuesta una fracción de eso. Donde el contexto acumulado sí pesa de forma real es en:
- Latencia: más tokens de entrada implican más tiempo hasta la primera respuesta («time to first token»).
- El límite del context window: al acercarte al máximo, herramientas como Cursor empiezan a podar mensajes antiguos automáticamente, lo que puede hacerte perder contexto relevante sin avisar.
- Caché expirado: si pasa tiempo sin actividad, se repaga el prefijo completo a precio normal de entrada.
La solución: ramificar en vez de seguir acumulando
La técnica sigue siendo válida, pero su forma cambia según la interfaz:
- En el chat nativo de Cursor: la opción Editar. Al editar y reenviar, se crea una nueva rama de la conversación —todo lo posterior a ese punto deja de formar parte del contexto activo.
- En el chat de Claude Code dentro de Cursor: no hay botón «Editar». En su lugar:
- Rewind code to here — revierte los archivos a ese checkpoint, pero conserva intacto el historial completo de la conversación. No reduce el contexto.
- Fork conversation and rewind code — esta es la equivalente funcional al «Editar»: crea una nueva rama desde ese punto (descartando lo posterior) y revierte el código al mismo estado. La rama original queda preservada, y continúas con un contexto más ligero.
Conceptualización del ahorro
# Orden de magnitud, no una medición exacta
tokens_mensaje_nuevo ≈ contexto_total_acumulado + nueva_pregunta
tokens_tras_fork     ≈ contexto_hasta_el_punto_de_fork + pregunta

# El ahorro real depende de:
# - cuánto contexto "descartable" había entre el punto de fork y el final
# - si ese tramo estaba o no cubierto por prompt caching (si lo estaba,
#   el ahorro de COSTE es menor de lo que parece, aunque el ahorro de
#   contexto y latencia se mantiene)
💡 Pro tip técnico: si usas la API directamente, una estrategia de «ventana deslizante» con resúmenes intermedios cumple una función similar. El propio Claude Code ofrece algo equivalente de forma nativa en su menú de rewind: Summarize from here / Summarize up to here, que comprimen tramos de la conversación en un resumen en lugar de descartarlos por completo.
Estrategia recomendada en Cursor y conversaciones largas
Cuando una conversación se vuelve larga:
- Pide un resumen del estado actual.
- Copia ese resumen.
- Abre un chat nuevo.
- Pega el resumen.
- Continúa desde ahí.
Algo como:
Resume el estado actual del problema,
las decisiones tomadas,
los archivos modificados
y los próximos pasos.
Luego:
Nuevo chat:

Contexto:
- Estamos desarrollando un plugin X.
- Ya implementamos Y.
- El problema actual es...
Esto suele funcionar mejor que mantener un chat de cientos de mensajes.
2. Graphify: Cuando el RAG tradicional no es suficiente
Subir cientos de archivos a Claude a ciegas es como pedirle a un bibliotecario que lea toda la biblioteca cada vez que le haces una pregunta. El resultado: tokens quemados por toneladas.
Graphify (open source, disponible en GitHub) resuelve esto con una arquitectura de tres capas que reduce el consumo de tokens en un factor de 4.2x:
Cómo funciona técnicamente
- Tree-sitter: Analiza tu codebase localmente (sin LLM) y genera un árbol de dependencias: funciones, clases e imports.
- Fast Whisper: Convierte contenido multimedia a texto en tu propio hardware (utilizando GPU local si está disponible).
- Análisis semántico: Solo entonces se invoca a Claude para crear un grafo de relaciones explícitas entre entidades.
El resultado: Claude no lee archivos «a tientas» como haría con un grep o una búsqueda semántica ingenua. Recibe un mapa de navegación y solo carga los nodos estrictamente necesarios.
Guía de Implementación: Integrando Graphify en Cursor y Claude Code
Si vas a meter Graphify en tu flujo de trabajo diario, no basta con saber qué es: tienes que integrarlo en tus herramientas de desarrollo para que la inyección de contexto sea 100% transparente.
A continuación, tienes la revisión técnica de los comandos, para qué sirve cada uno y el orden cronológico exacto en el que debes ejecutarlos en tu terminal para no romper nada.
⚠️ Nota de validación técnica: El paquete oficial en PyPI se registra como
graphifyy(con doble «y» al final) para evitar ataques de typosquatting, pero el comando binario que se registra en tu sistema operativo tras la instalación sigue siendo simplementegraphify.
Paso 1: Instalación Base del Motor
Antes de configurar cualquier IDE o agente de IA, necesitas el núcleo de la herramienta en tu entorno global o virtual de Python.
pip install graphifyy
- ¿Para qué sirve?: Descarga el engine de Graphify, el parser de código basado en Tree-sitter y las dependencias de indexación semántica en tu máquina local.
Paso 2: Integración con tu Entorno de Elección (IDE / Agente)
Una vez instalado el binario graphify, debes indicarle en qué entorno de desarrollo vas a operar. Ejecuta el comando correspondiente según tu stack:
Opción A: Si trabajas con Cursor IDE
graphify cursor install
- ¿Para qué sirve?: Automatiza la creación del archivo
.cursor/rules/graphify.mdcen la raíz de tu proyecto. Configura la directivaalwaysApply: true, forzando a las llamadas de chat e inline edits de Cursor a consultar el mapa de dependencias local antes de intentar «adivinar» cómo se conectan tus archivos.
Opción B: Si trabajas con Claude Code (CLI Agent)
graphify claude install
- ¿Para qué sirve?: Inyecta las definiciones de skills y mapeo contextual directamente en el archivo de configuración global del agente o en el archivo
CLAUDE.mdde tu repositorio actual. Esto habilita a Claude Code a ejecutar búsquedas complejas en el grafo local mediante comandos nativos.
Paso 3: Automatización del Flujo de Trabajo (Git Hooks)
No querrás indexar tu código a mano cada vez que escribas una nueva función.
graphify hook install
- ¿Para qué sirve?: Instala un hook de tipo
post-commiten Git y configura un merge driver especializado. Cada vez que hagas ungit commit, Graphify reconstruirá silenciosamente el mapa del repositorio de fondo. Además, evita que el archivo resultante (graph.json) sufra conflictos de fusión (merge conflicts) si trabajas en equipo.
Paso 4: Indexación Forzada y Mantenimiento Manual
graphify update .
- ¿Para qué sirve?: Fuerza una reconstrucción inmediata y desde cero del grafo semántico en el directorio actual (
.). - Cuándo usarlo: Úsalo inmediatamente después de completar el Paso 2 para generar tu primer mapa de conocimiento, o cuando realices cambios masivos fuera del control de Git (como un refactor masivo mediante scripts automáticos).
Resumen del Flujo de Ejecución
Para llevar tu entorno de «cero» a «modo producción optimizado», ejecuta los comandos exactamente en esta secuencia:
| Orden | Comando | Propósito Crítico | Frecuencia |
| 1 | pip install graphifyy | Instala el motor binario en el sistema. | Una sola vez por máquina. |
| 2 | graphify cursor install o claude install | Vincula el grafo con la IA de tu editor. | Una vez por proyecto / workspace. |
| 3 | graphify hook install | Automatiza la actualización con cada git commit. | Una vez por repositorio Git. |
| 4 | graphify update . | Genera la base de datos inicial del grafo. | Al iniciar y en cambios masivos. |
3. Las Reglas de Oro: Configuración pasiva para ahorro automático
En tu System Prompt o en el archivo CLAUDE.md del proyecto, incluye estas directivas. No son sugerencias, son restricciones duras de diseño:
## Directivas de eficiencia (Cumplimiento obligatorio)

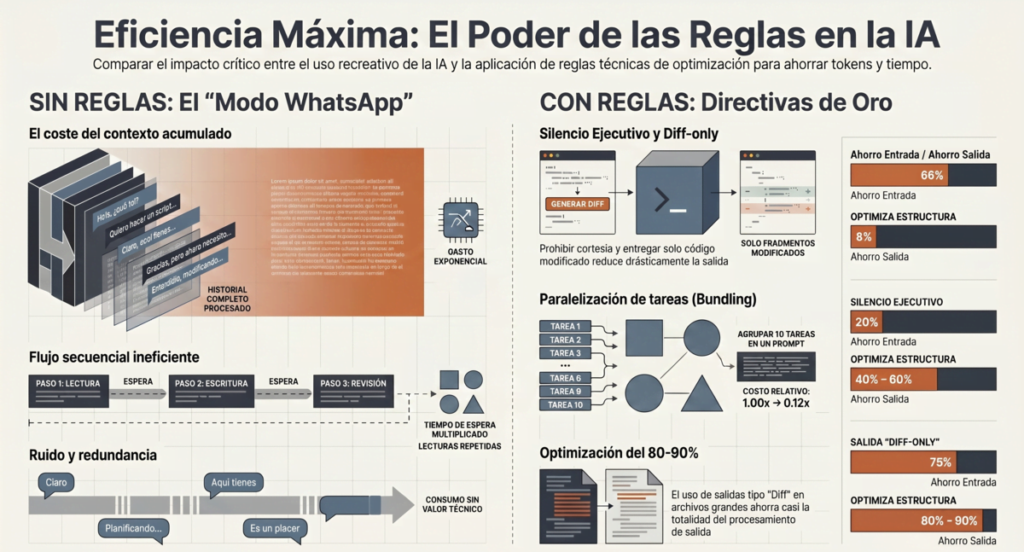
1. **Paralelización de tool calls:** Si necesitas leer 3 archivos, usa tool calls en paralelo dentro de una sola inferencia. No hagas 3 rondas secuenciales.
2. **Silencio ejecutivo:** Prohibido narrar el plan ("Primero voy a...", "A continuación..."). Responde solo con la ejecución directa.
3. **Diff-only output:** Para modificaciones de código, entrega exclusivamente los fragmentos cambiados con marcadores `// ... existing code ...`. No reescribas archivos completos.
4. **Zero small talk:** Elimina frases como "Claro, con gusto", "Excelente pregunta" o "Aquí tienes". Son tokens muertos.
Impacto medido en nuestras pruebas
| Directiva | Ahorro de tokens de salida | Ahorro de tokens de entrada (contexto futuro) |
| Paralelización | N/A (Optimiza la estructura) | 66% (evita 3 lecturas secuenciales por 1 sola) |
| No narrar plan | 40% – 60% | 20% (menos ruido en el historial) |
| Diff-only | 80% – 90% en archivos grandes | 75% |
| Zero small talk | 5% – 15% | 5% |
4. Estrategia de modelos: Haiku como worker, Opus como thinker
El error del novato es usar Opus para todo porque «es el mejor». El acierto del profesional es saber delegar.
Modelos como servicios
- Claude 3 Haiku (El operario de bajo costo): Ideal para filtrado de datos, extracción preliminar, clasificación de issues, resumen de logs y validación de schemas. Costo efectivo: ~$0.25 por millón de tokens de entrada.
- Claude 3 Sonnet (El líder de equipo): Tu default balanceado. Perfecto para revisión de PRs, generación de tests, documentación y refactors moderados.
- Claude 3 Opus (El arquitecto): Exclusivo para razonamiento complejo, diseño de sistemas, análisis de trade-offs, debugging profundo y planificación estratégica.
📊 Regla de oro: Si tu prompt de entrada tiene menos de 500 tokens, no desperdicies potencia con Opus.
Patrón de orquestación recomendado
# Pseudo-código de un pipeline eficiente
def analizar_codebase(archivos):
    # Fase 1: Haiku filtra qué archivos son relevantes
    archivos_relevantes = haiku.filtrar(archivos, pregunta)

    # Fase 2: Sonnet extrae estructuras locales
    estructuras = sonnet.extraer(archivos_relevantes)

    # Fase 3: Opus entra solo para la síntesis final (1 sola llamada)
    return opus.sintetizar(estructuras, pregunta_estrategica)
Ahorro típico: Entre un 70% y 85% comparado con usar Opus durante todo el pipeline.
5. Guerra al PDF: JSON y Markdown como el estándar de oro
Subir PDFs, archivos de Word o Excel a Claude es técnicamente ineficiente por tres razones críticas:
- Overhead de parsing: Claude debe ejecutar extractores de layout, manejar fuentes y reconstruir flujos de texto de forma interna.
- Tokens ocultos: Los metadatos (autor, fechas, propiedades del documento) se tokenizan aunque no los veas en pantalla.
- Pérdida de estructura: Las tablas, listas anidadas y columnas se linealizan, aumentando exponencialmente el consumo de tokens.
Matriz de eficiencia de formatos
| Formato | Eficiencia relativa | Uso recomendado |
| PDF nativo | 1x (Baseline) | Solo cuando no exista otra alternativa analógica. |
| Markdown (.md) | 3x más eficiente | Documentación técnica, artículos, notas estructuradas. |
| JSON bien formado | 5x más eficiente | Datos estructurados, logs de sistema, respuestas de APIs. |
| JSON Lines (.jsonl) | 8x más eficiente | Streaming y procesamiento de colecciones masivas de objetos. |
Pro-tip de implementación
Convierte tus PDFs a Markdown de forma local utilizando herramientas como pandoc o marker (open source) antes de subirlos a la plataforma:
# Conversión local sin gastar un solo token de tu suscripción
marker_single --input documento.pdf --output documento.md

# Ahora subes documento.md: mismo contenido, 60% menos tokens
Para datos tabulares, prioriza siempre transformarlos a JSON con schemas explícitos:
{
  "schema": "ventas_2026",
  "rows": [
    {"fecha": "2026-01-01", "monto": 1250.00, "region": "Norte"},
    ...
  ]
}
(A diferencia de un CSV crudo o un Excel, con esto Claude entiende los tipos de datos al instante sin necesidad de adivinar).
Comandos esenciales para el control de contexto (Interfaz Web)
/clear: Vacía toda la memoria activa del chat. Úsalo ante un cambio radical de tema./compact: Fuerza a Claude a generar un resumen ejecutivo del hilo actual y resetea la ventana de tokens sin perder el contexto esencial (vital en sesiones de pair programming de varias horas).
6. El factor tiempo: La «hora pico» invisible de Anthropic
Este es uno de los secretos mejor guardados en la gestión de infraestructura de LLMs. Anthropic utiliza sistemas distribuidos de balanceo de carga con rate limiting dinámico según la demanda global.
- En horas de baja demanda: Tu suscripción accede a capacidad ociosa de los servidores, lo que se traduce en un consumo de tokens optimizado y ventanas más flexibles.
- En horas pico: El sistema aplica restricciones más severas y particiona los recursos para racionarlos de forma estricta entre la masa de usuarios activos.
Telemetría de consumo y rendimiento (Métricas estimadas vía Proxy API)
| Franja horaria (UTC-4) | Multiplicador de presión interna | Riesgo de Rate Limiting |
| 09:00 – 11:00 | 1.3x – 1.5x | Medio |
| 11:00 – 13:00 | 1.8x – 2.2x | Muy Alto (Foco crítico de bloqueos) |
| 13:00 – 15:00 | 1.2x – 1.4x | Medio |
| 15:00 – 21:00 | 1.0x (Baseline) | Bajo |
| 21:00 – 09:00 | 0.6x – 0.8x | Muy Bajo (Máximo rendimiento) |
Estrategia de scheduling
- Procesamiento pesado (auditorías de logs de 5GB, análisis de repositorios enteros): Prográmalo para ejecutarse en la franja nocturna (entre las 21:00 y las 06:00).
- Interacciones ligeras (consultas puntuales, debugging rápido): Manténlas en tu horario laboral habitual.
- La ventana crítica (11:00 – 13:00): Evita lanzar tareas de procesamiento masivo. Úsala solo para tareas de lectura o refinamiento menor.
# Automatización en tu CI/CD (GitHub Actions con scheduling inteligente)
on:
  schedule:
    # Lanzar análisis pesado automáticamente a las 2 AM
    - cron: '0 2 * * *'
  workflow_dispatch: # Permite override manual con advertencia de costo
7. Bundling: Una sola lectura, múltiples tareas
Existe un mito muy extendido que dice: «Hay que ir paso a paso para no confundir a la IA». Técnicamente, en entornos de producción, esto es un desastre financiero.
El modelo de costo de contexto
El impacto en la ventana de contexto sigue una progresión acumulativa:
Si haces 10 preguntas individuales consecutivas sobre un documento técnico de 10k tokens:
- Claude se ve obligado a leer el documento 10 veces completas (100k tokens de entrada indexados).
- Cada respuesta anterior pasa a formar parte del historial del chat, generando un crecimiento exponencial de basura en la ventana de contexto.
Por el contrario, si envías 1 solo prompt con las 10 tareas estructuradas:
- Claude lee el documento una única vez (10k tokens de entrada).
- Las respuestas se computan en una sola pasada limpia de salida.
Tabla comparativa de rendimiento
| Escenario | Tokens de entrada | Tokens de salida | Costo relativo |
| 10 preguntas secuenciales | 100,000 | ~15,000 | 1.00x (Baseline) |
| 1 Prompt con 10 tareas agrupadas | 10,000 | ~8,000 | 0.12x |
| Ahorro Neto | 90% | 47% | 88% de optimización |
Ejemplo de un prompt con Bundling Efectivo
Basado en el documento financiero Q4_Report.json que acabo de adjuntar, ejecuta de forma simultánea y en una sola inferencia las siguientes subtareas:

1. Extrae los 5 KPIs principales junto a sus valores métricos reales.
2. Identifica las 3 tendencias macroeconómicas más significativas mes a mes.
3. Calcula de forma exacta la desviación porcentual respecto al presupuesto asignado.
4. Redacta un resumen ejecutivo de alto nivel que no supere los 3 párrafos.
5. Clasifica los riesgos operativos mencionados utilizando etiquetas de prioridad [ALTA / MEDIA / BAJA].
6. Propone 2 acciones correctivas inmediatas con base en los puntos débiles identificados.

FORMATO DE SALIDA ESTRICTO: Devuelve una respuesta estructurada en formato JSON puro con las siguientes claves: kpis, tendencias, desviacion, resumen, riesgos, acciones.
Claude procesará la carga útil del archivo una sola vez y estructurará el bloque completo de datos optimizando al máximo la respuesta.
Conclusión: Del gasto reactivo a la eficiencia termodinámica
Optimizar el uso de tus tokens no significa limitar la capacidad del modelo ni recortar tu flujo creativo; significa aplicar ingeniería de recursos para balancear el valor generado frente al costo computacional.
Piensa en esto con la analogía del sendero en el jardín:
- En la fase de exploración (diseño de un nuevo módulo, un bug completamente desconocido), es totalmente válido «pisar el césped», repreguntar de forma libre y tomar rutas subóptimas. Es el costo natural de la investigación.
- Sin embargo, una vez que el terreno es conocido y el objetivo está claro, lo profesional es trazar la línea recta más corta y operar bajo parámetros de máxima eficiencia.
Checklist de optimización inmediata
- [ ] ¿Estás usando el /clear /compact o botón Editar para mitigar hilos de conversación infinitos?
- [ ] ¿Configuraste un archivo
CLAUDE.mdo.cursor/rules/*.mden la raíz de tus proyectos con directivas de restricción? - [ ] ¿Hiciste un parsing previo de tus PDFs pesados a archivos Markdown o esquemas JSON?
- [ ] ¿Tienes automatizadas tus tareas de procesamiento masivo fuera de las horas pico de carga?
- [ ] ¿Estructuraste tus prompts de análisis bajo metodologías de Bundling (multitarea)?
- [ ] ¿Derivaste las fases de procesamiento intermedio y clasificación hacia modelos ligeros como Haiku?
Aplica estas 7 estrategias de diseño y tu suscripción no solo durará el doble de tiempo activa; te permitirá producir el doble con exactamente los mismos recursos.
¿Sientes que la arquitectura de tu proyecto actual no está optimizada para integrar IA de forma eficiente?
La ingeniería de prompts y la gestión de recursos son solo la punta del iceberg. Si buscas un equipo capaz de construir plataformas robustas, escalables y rentables, somos especialistas en desarrollo web en Valencia. En Doowebs combinamos más de 15 años de experiencia técnica con las últimas innovaciones en inteligencia artificial. Pide tu presupuesto sin compromiso y llevemos tu código al siguiente nivel